一站式训练任务
任务名、底模路径、VAE、Text Encoder、优化器、学习率、网络维度、混合精度,全部在同一个表单里配好。保存后随时回来改。
无需命令行不用再在 ComfyUI、脚本命令、素材工具之间来回切换。从素材整理到 LoRA 产出,链路完整。
任务名、底模路径、VAE、Text Encoder、优化器、学习率、网络维度、混合精度,全部在同一个表单里配好。保存后随时回来改。
无需命令行选了显卡与数据集之后自动配置训练参数,按钮默认即可开训。不用查文档、不用试错,改都不用改就能跑出第一条结果。
零调参上手内置 Qwen3-VL、Qwen3.5、JoyCaption、ACE-Step 多套打标方案,批量生成高质量训练标签。支持统一打标、仅主标签、中英互译。
省掉逐张手写训练过程中按轮次或步数自动出采样图,Loss 曲线与学习率实时绘制。训练完的 safetensors 直接在应用内预览。
边训边看已用时间、预计剩余、日志与关键状态实时展示。长训不再黑盒等待,出问题第一时间能在日志里看到。
长训不抓瞎图片裁剪、压缩、图片对比、格式转换、视频抽帧、批量重命名。训练素材的预处理不用再开第二个软件。
6 个工具FP8 底模存储 + 块交换(Block Swap),让 14B 级模型在消费级显卡上跑得动。22GB 显存可训 Wan2.2 14B。
FP8 + Block SwapZ-Image Base、HunyuanVideo1.5 等底模训练出的权重需要转格式才能被 ComfyUI 识别,应用内一键转换。
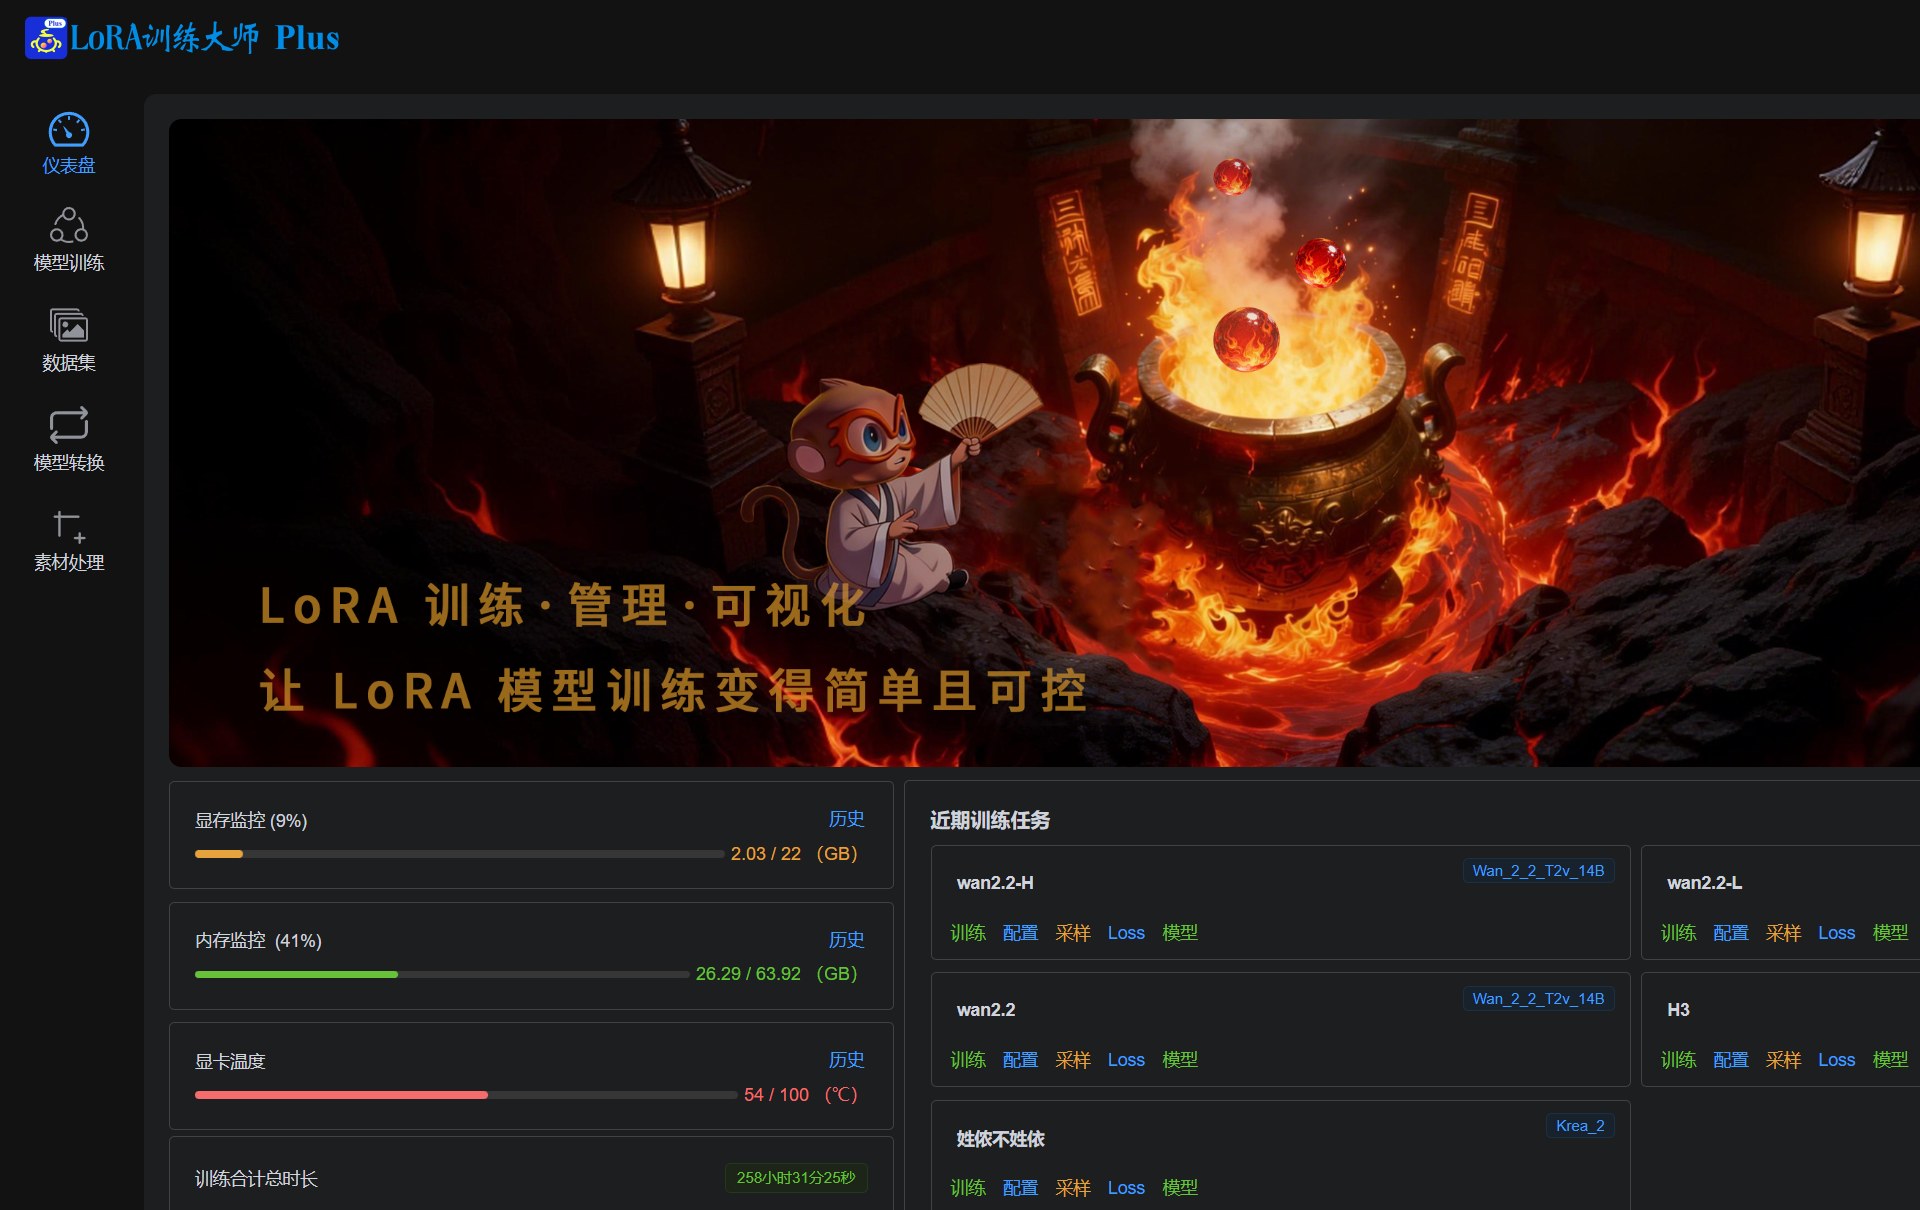
直连 ComfyUI显存占用、内存占用、显卡温度三项指标实时刷新并保存历史记录,训练跑多久、温度有没有压住,一眼看清。
训练历史留存底模选好后,训练参数(分辨率、flow_shift、网络维度、学习率、时间步采样)会自动填好该架构的推荐默认值,不需要你自己查资料。
数量按 5.5.0 实际可选的模型类型统计。部分架构提供多个变体(如 Wan2.1 I2V 分480P / 720P), 训练前需要先下载对应架构的底模权重。
数据集建好后直接进「自动打标」,选一个打标引擎批量跑一遍,每张素材旁边就多一个同名 .txt。 全部在本机推理,不上传任何素材。
数据集详情页 · 打标与语言选项
以下界面均来自 5.5.0 版本实际运行,未做任何修饰。
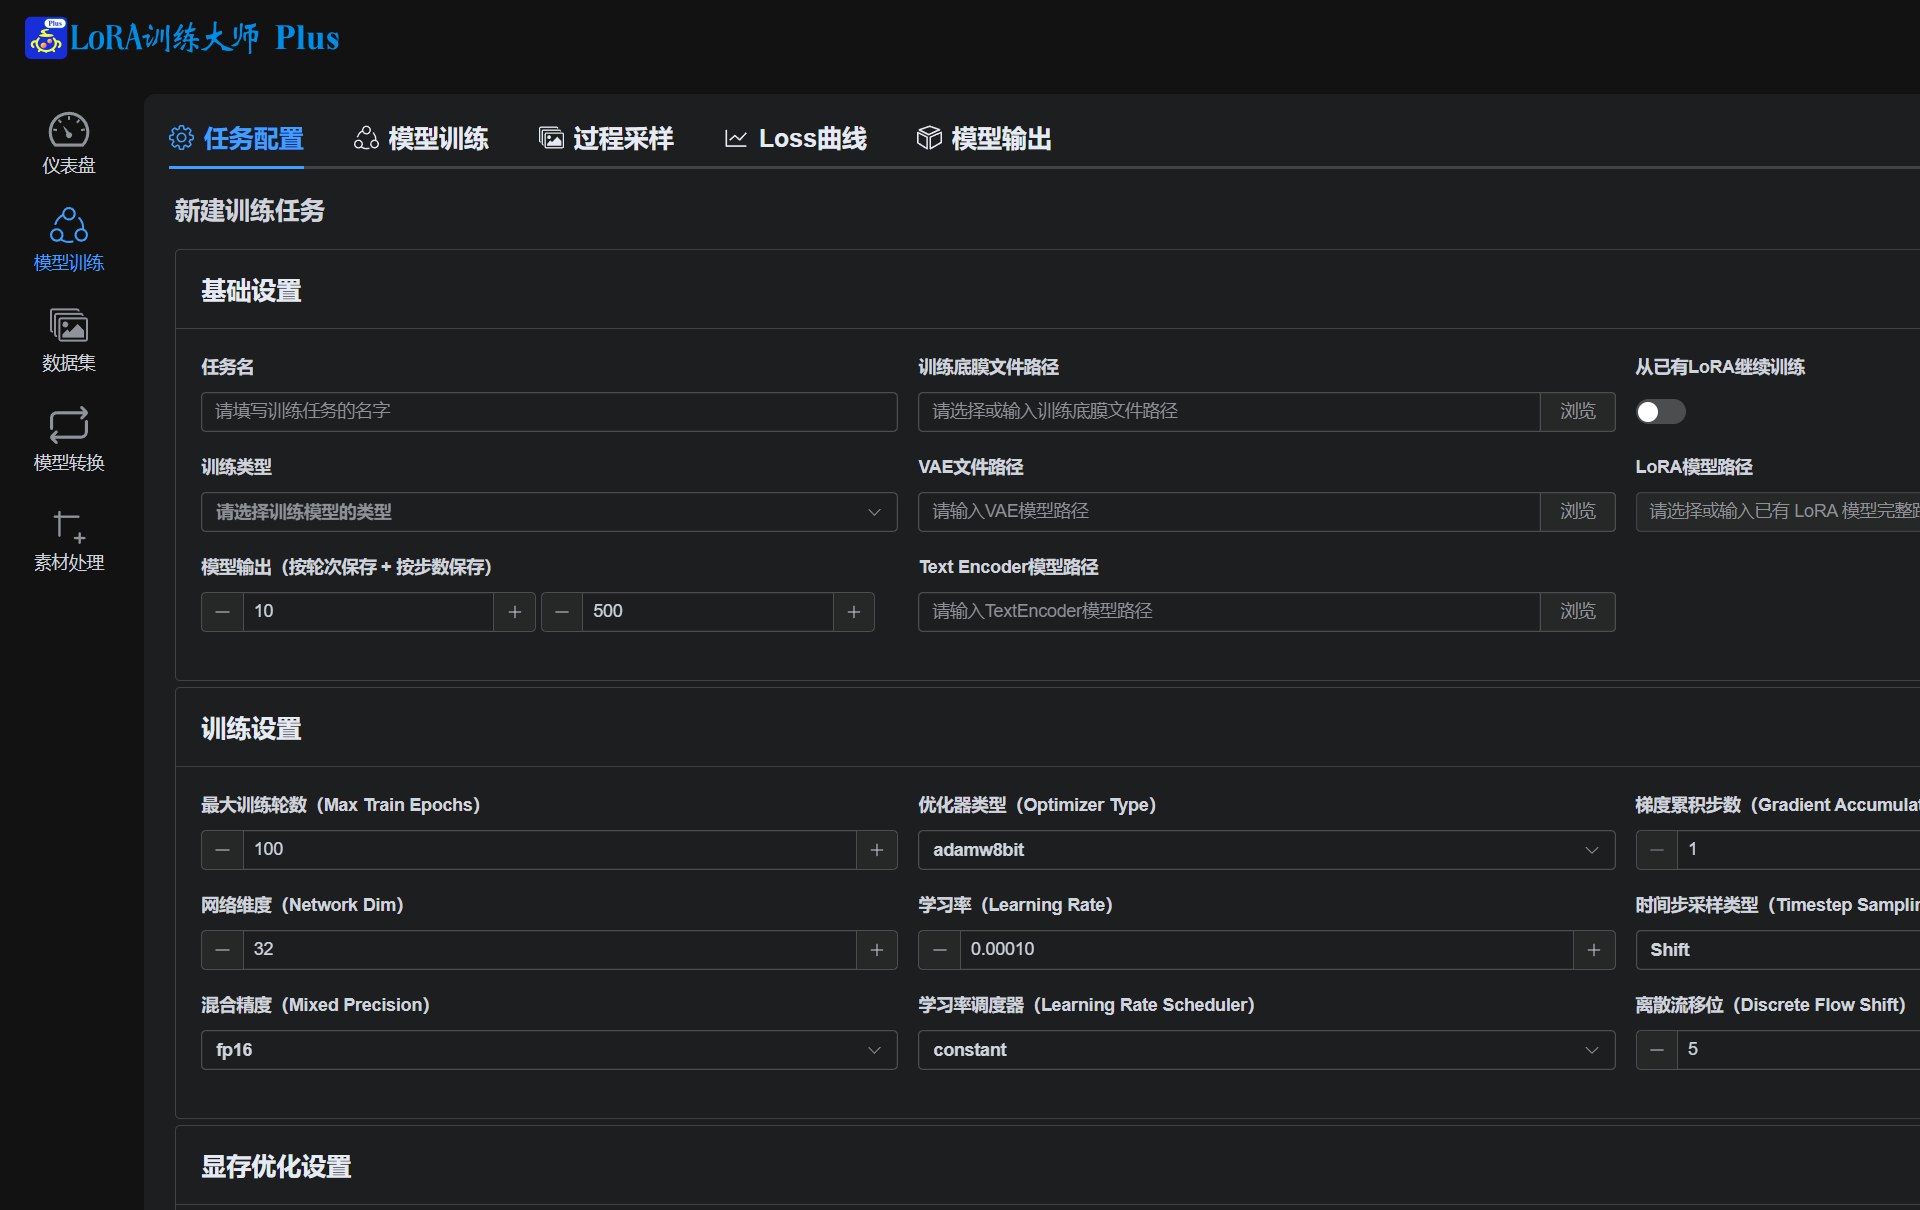
基础设置(任务名、底模/VAE/Text Encoder 路径、输出频率)、训练设置(轮次、优化器、网络维度、学习率、时间步采样、混合精度)、显存优化设置分区排列。每个字段都有中文标签与英文原名对照,改错了也知道对应哪个参数。
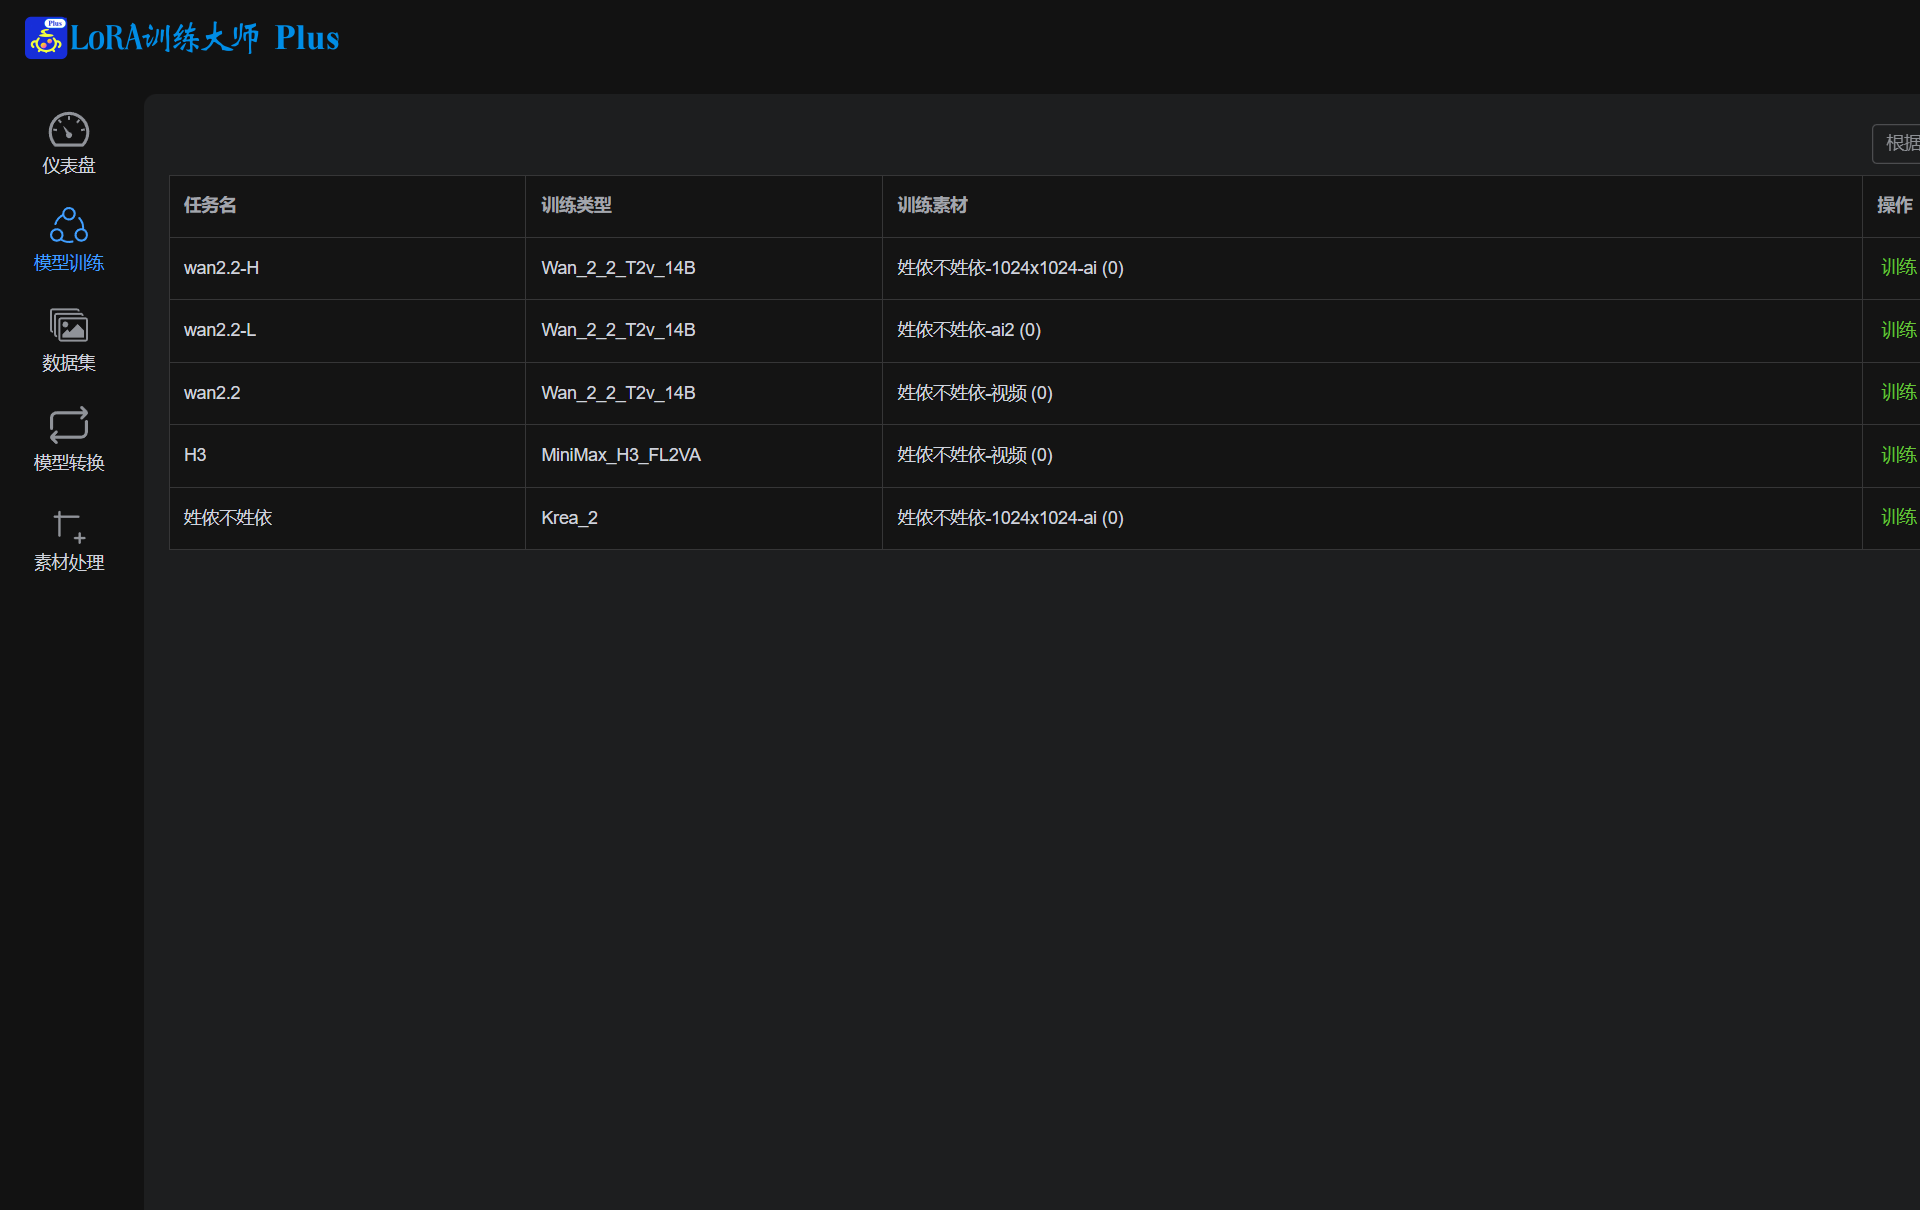
每个任务独立记录训练类型与素材数量,可直接跳转训练、配置、采样、Loss 曲线与模型输出五个视图。
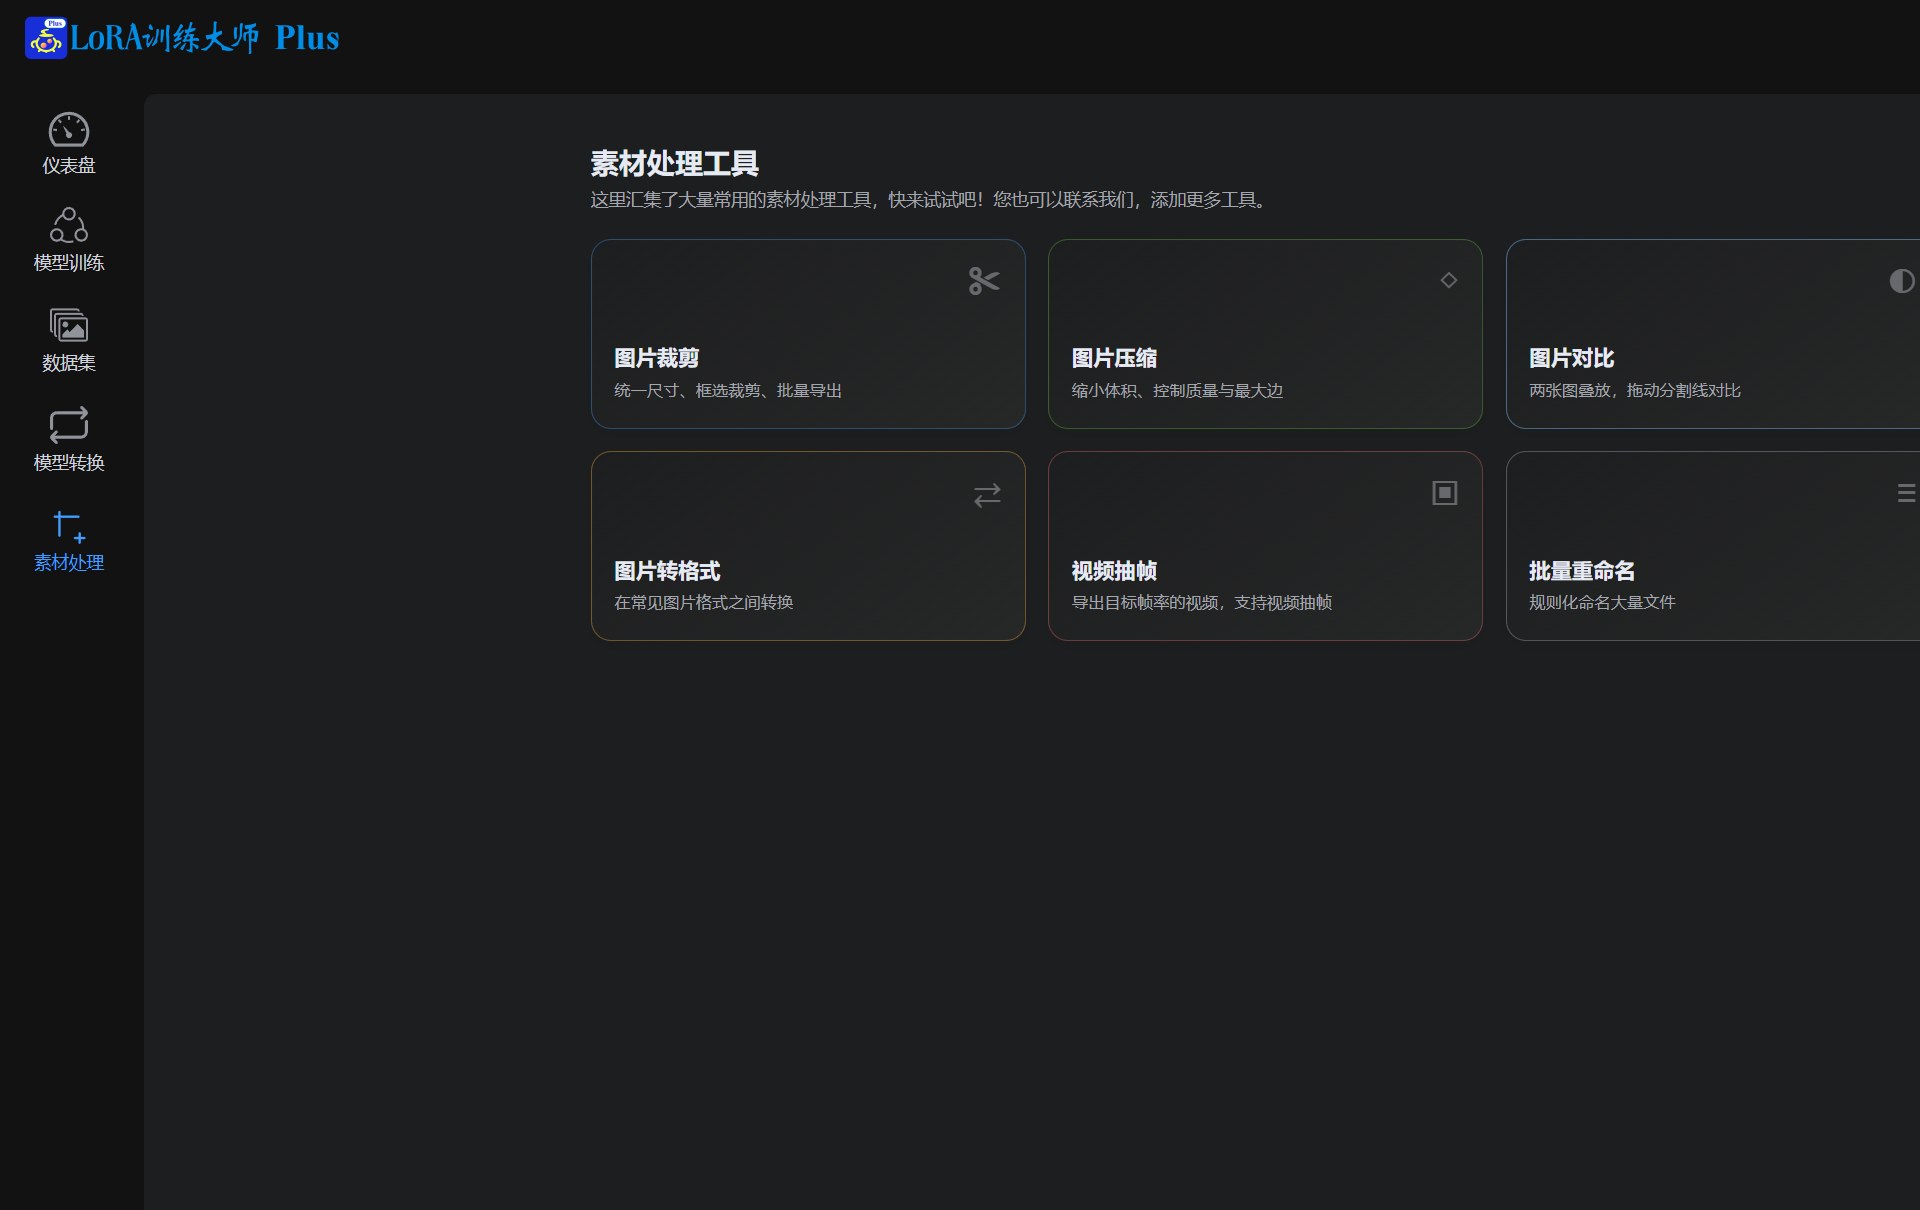
六个常用工具统一入口:图片裁剪、图片压缩、图片对比、图片转格式、视频抽帧、批量重命名,都是批量处理 + ZIP 导出。
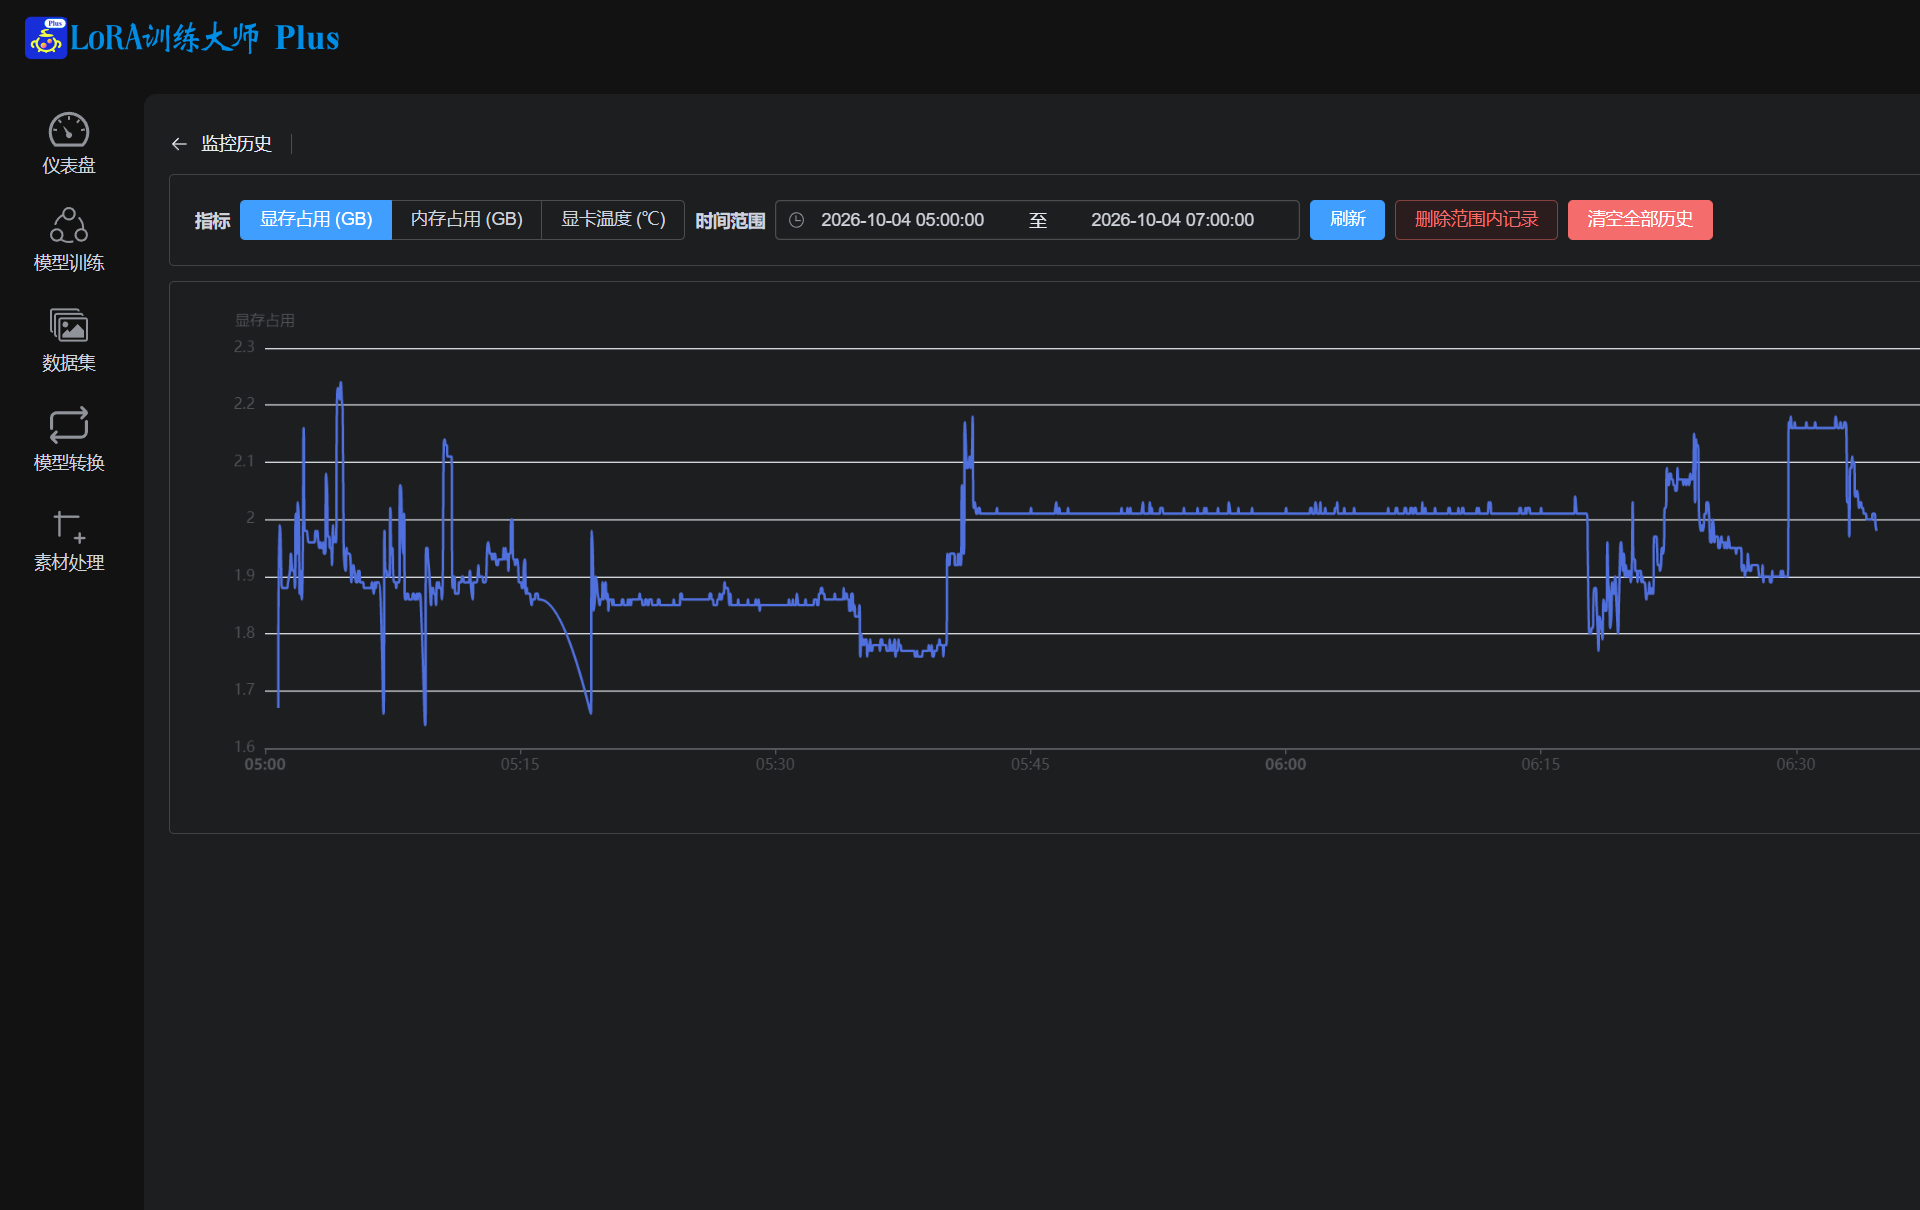
显存、内存、显卡温度按时间范围绘制曲线,可按区间删除或清空全部记录,用来判断训练时是否温度降不下来。
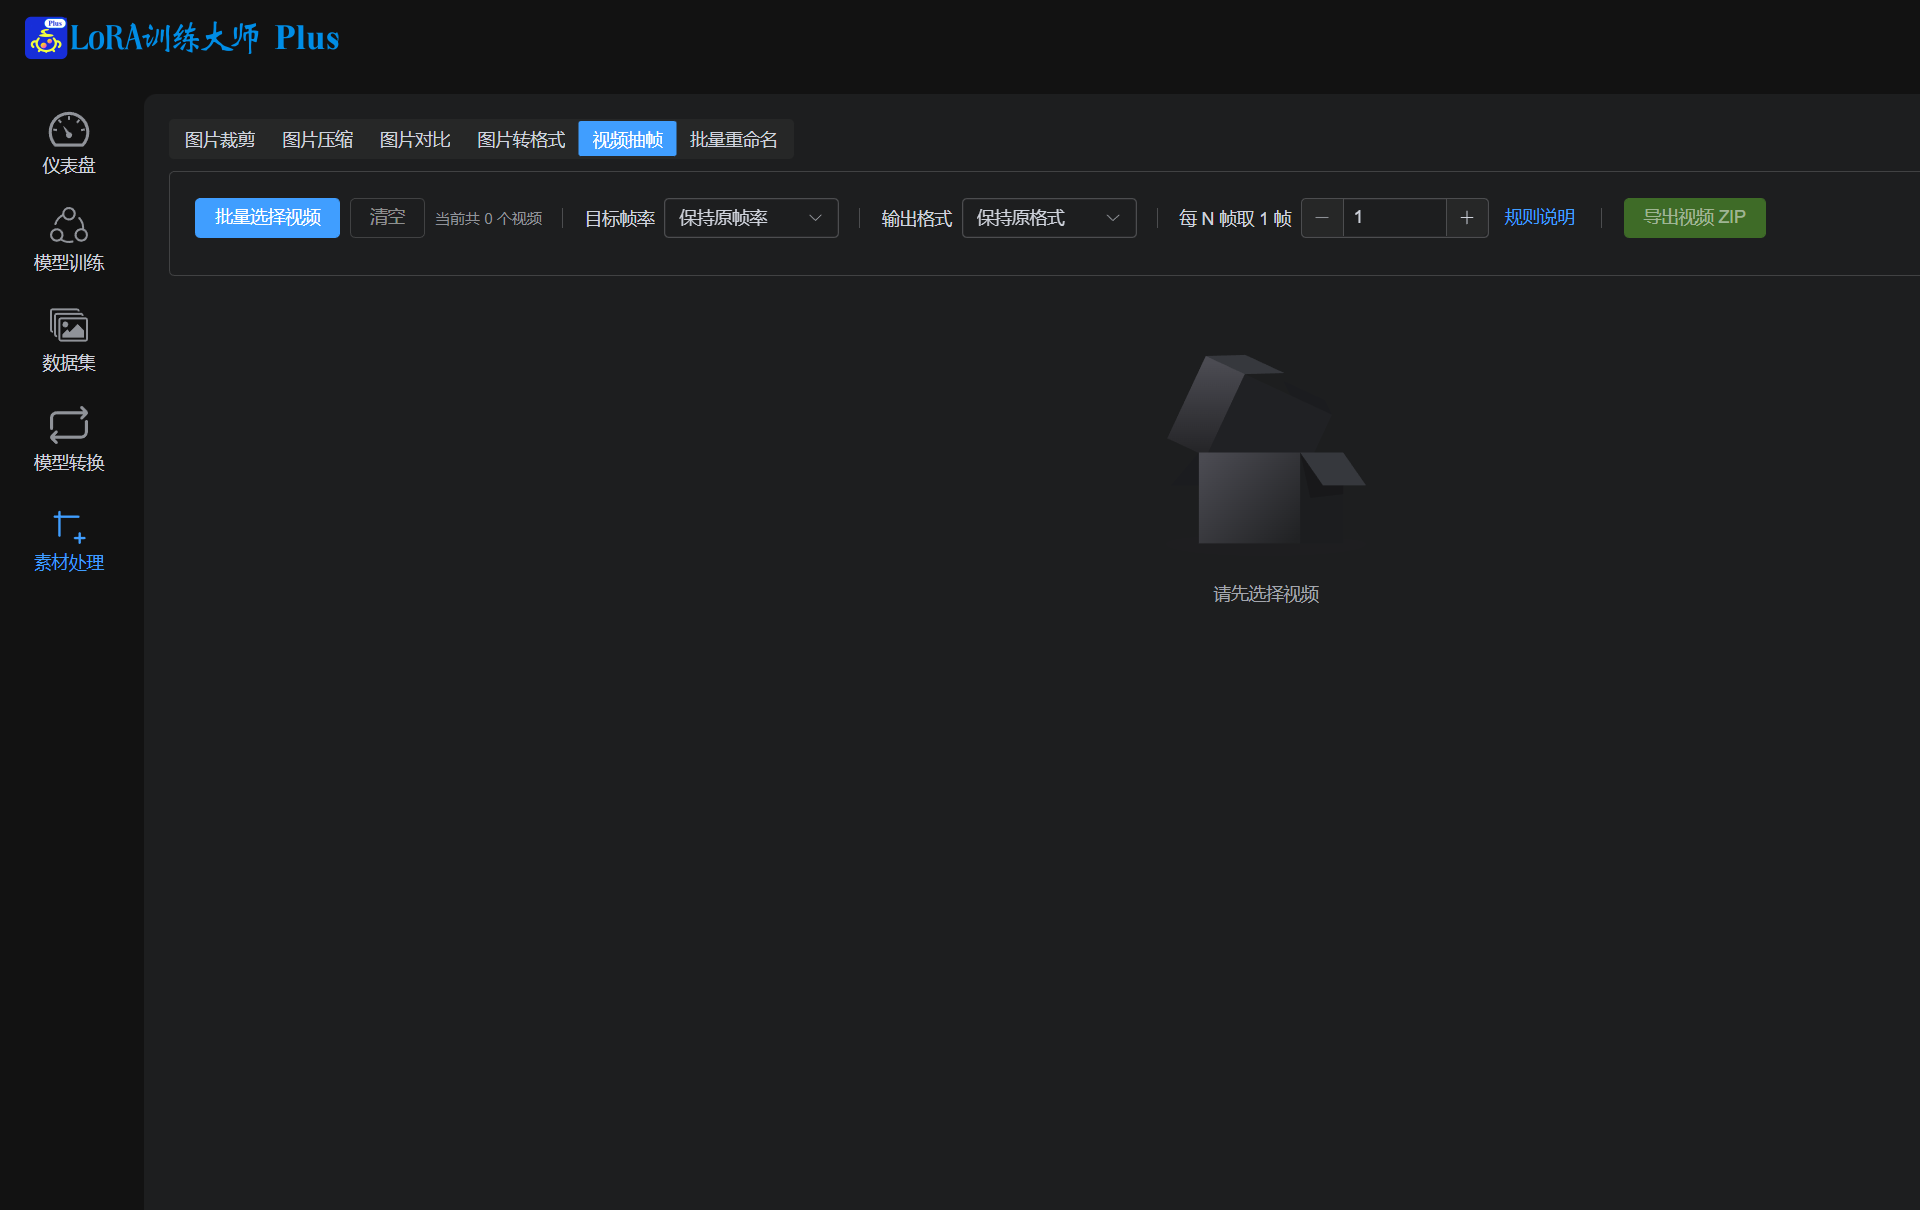
做视频 LoRA 的必备一步。批量选择视频,设置目标帧率或按「每 N 帧取 1」抽帧,输出格式可选,支持直接导出 ZIP。
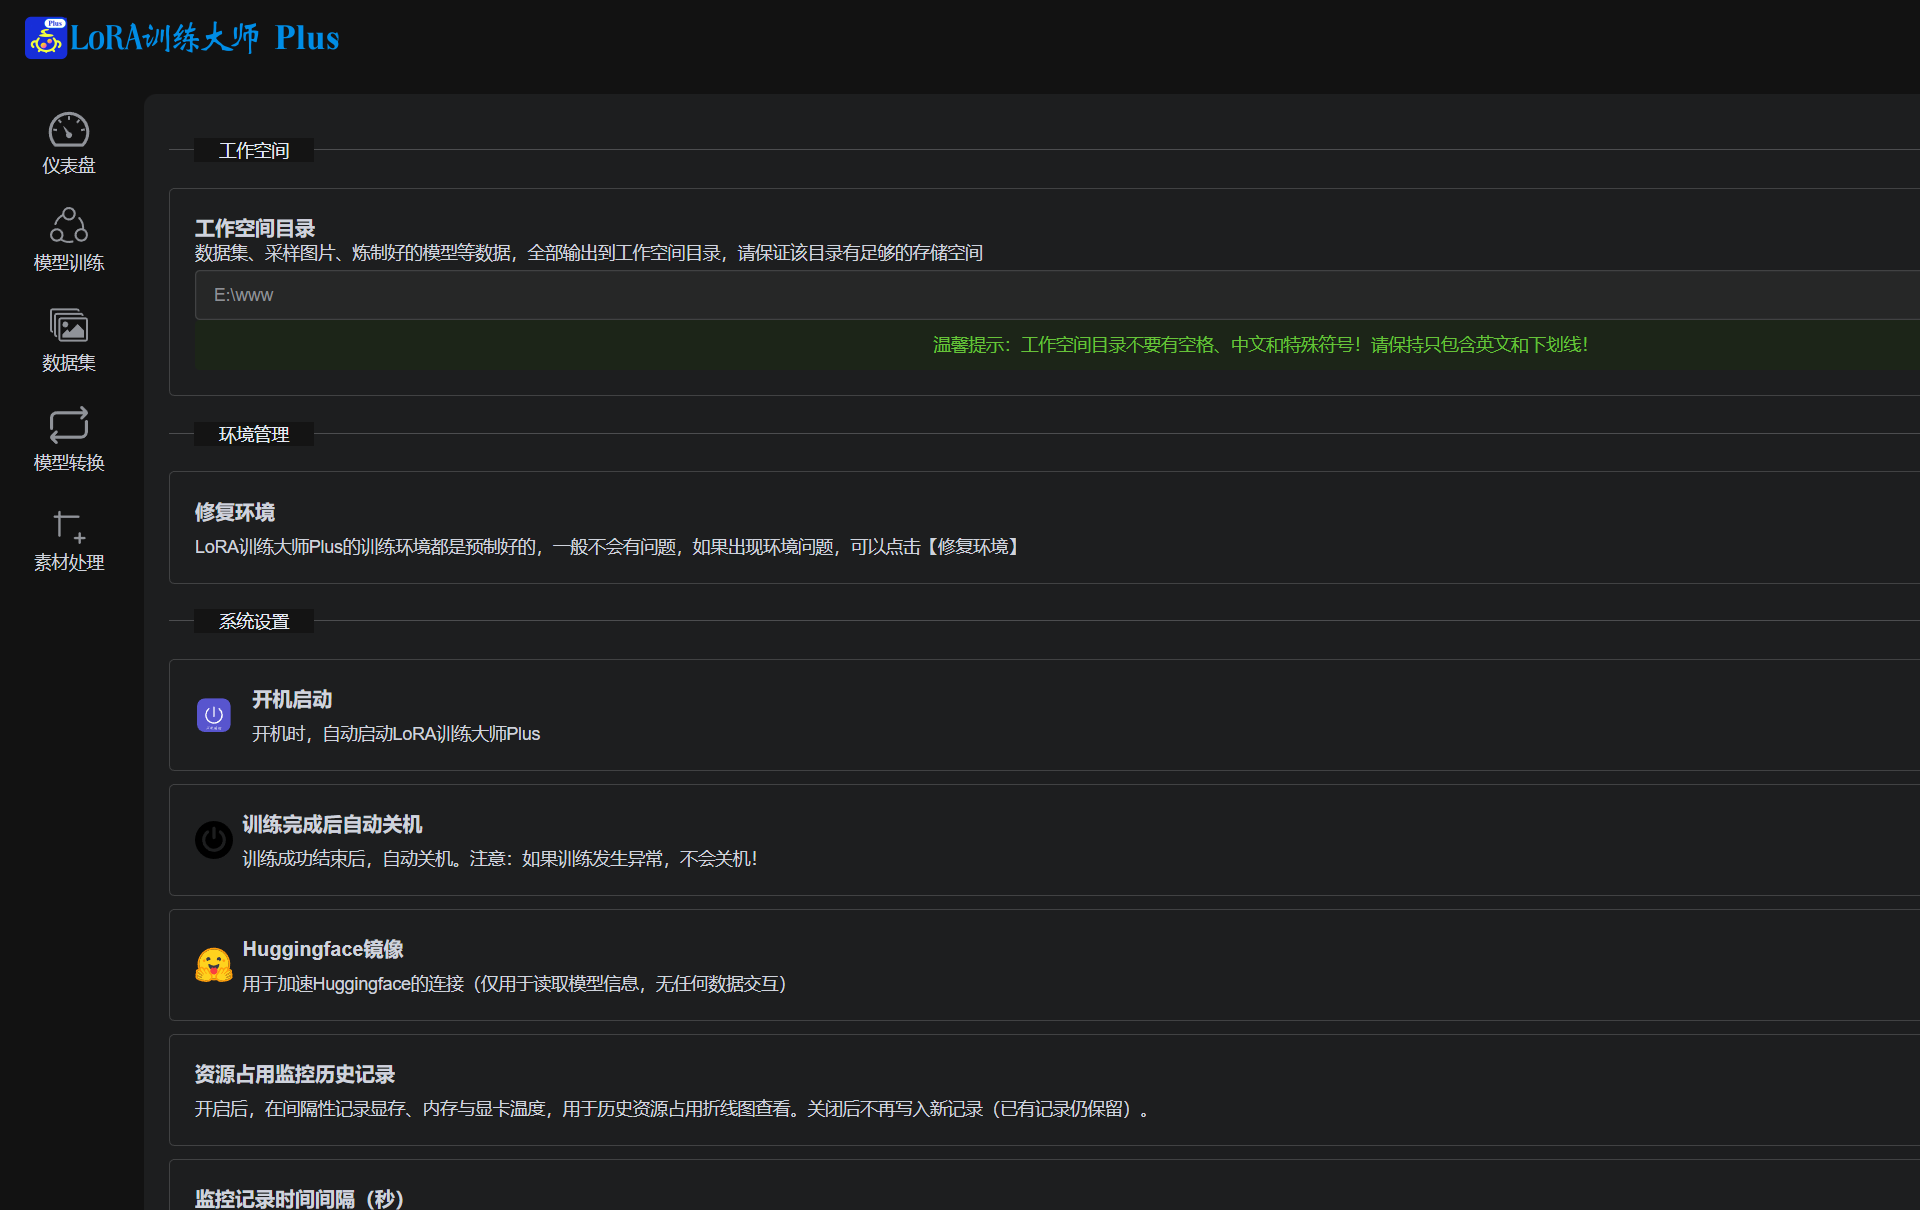
指定工作空间目录(数据集、采样图、产出模型都放这里)、一键修复 Python 环境、开机自启、训练完成自动关机、Huggingface 镜像、资源占用监控记录。
整个流程没有需要记忆的命令行参数。第一次用建议先拿 20~30 张素材的小数据集跑通一遍。
在「素材处理」里把图片统一裁剪到目标尺寸并压缩。做视频 LoRA 先用视频抽帧把视频拆成帧序列。
裁剪 → 压缩 → 导出 ZIP
新建数据集导入素材,点「自动打标」批量生成 .txt 标签。可以只保留主标签,也可以中英互译。
自动打标 → Qwen3-VL
仅主标签 ●── 开
训练语言 ● 中文
在「模型训练」新建任务,选好模型类型后参数自动填默认值,再按你的显存与素材量调整网络维度和轮次。
训练类型   Wan_2_2_T2v_14B
网络维度   32
最大轮次   100
优化器     adamw8bit
训练完成后在「模型输出」里找到 .safetensors,复制到 ComfyUI 的 models/loras 即可加载。任务名要唯一,否则会互相覆盖。
ComfyUI/models/loras/
└─ 你的角色.safetensors
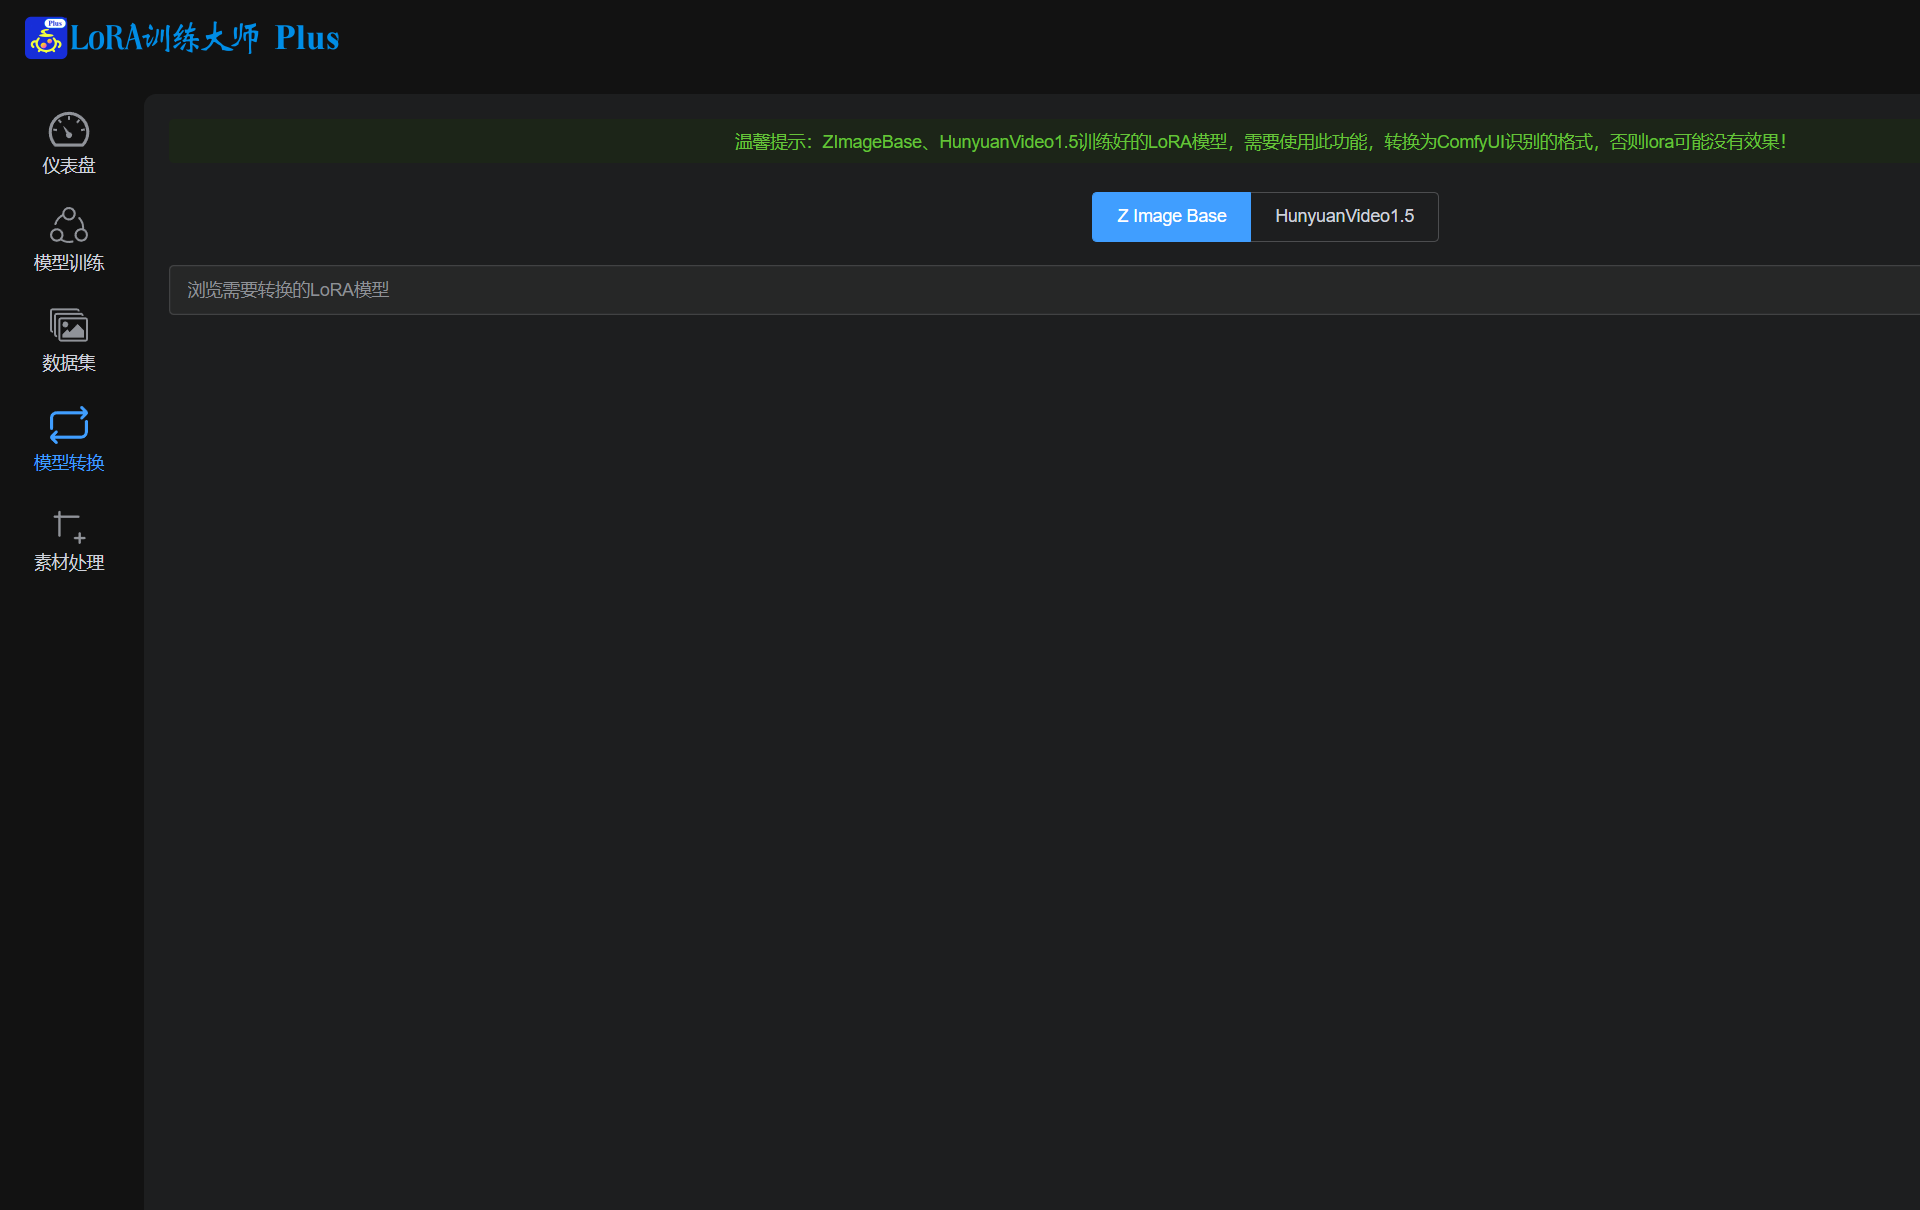
这两类底模训练出的权重不能被 ComfyUI 直接识别,加载了也不会生效。必须用「模型转换」功能转一遍——选模型、选文件、转换,三步完成,不用手动改任何文件。
其余底模(Wan2.2、Qwen-Image、Flux、Krea2、LTX2 等)训练出的 LoRA 可以直接放进 models/loras 使用。
不需要。5 套训练后端各带便携 Python 3.12 与 PyTorch 运行时,解压即用,不用配环境变量,也不用单独装 CUDA Toolkit(显卡驱动仍需自行安装)。
支持。Plus 版已移除在线校验与自动更新,运行期间不连接任何服务器,训练与数据处理全在本机完成。只有首次下载底模文件时需要联网。
因为训练后端与 PyTorch 运行时全部内置了,这样你不用自己配环境。应用本体(不含训练环境)只有约 170MB,训练后端占了绝大部分。
22GB 显存的显卡可以跑 Wan2.2 14B(需开 FP8 底模存储)。8GB 显卡建议先降分辨率与目标帧数。块交换依赖内存,训练前请把系统可用内存留到 30GB 以上。
绝大多数底模可以直接放进 ComfyUI 的 models/loras 目录。Z-Image Base 与 HunyuanVideo1.5 需要先用「模型转换」功能转格式,否则 LoRA 不生效。
不用。默认的 both 模式会在同一套权重上同时训练高低噪专家。如果你要两套独立权重,才需要拆成 low_only 与 high_only 两个任务各跑一次。
不要有空格、中文和特殊符号,否则 Python 环境可能出问题。应用设置页有红色提示,改完目录建议点一次「修复环境」验证。
不需要。打标在本机推理,素材不出本机。首次使用某个打标引擎需要下载对应的模型权重,之后就完全离线了。
追求细节描述用 Qwen3-VL 8B-Instruct;想要长描述和风格描述用 Qwen3.5(4B/9B/27B);追求速度用 JoyCaption。音频模型训练用 ACE-Step。多数情况下 Qwen3-VL 的默认设置就够用。
数据集里可以指定「训练使用语言」,应用会按你选的语言走对应标签。做 Flux、SDXL 这类英文生态的底模建议英文标签;Qwen-Image、Wan 系列的 caption 本身偏中文,中文标签效果更稳。
优先开「FP8 底模存储」与块交换(Block Swap),14B 级模型在 22GB 卡上能跑起来。还爆就把训练分辨率或视频帧桶调小一档——注意改分辨率需要重算缓存。另外训练期间别同时开 ComfyUI 生图,它会抢走显存。
缓存阶段最久:视频数据集逐帧编码潜空间与文本编码器输出,素材多时可能跑几小时。缓存按任务独立保存、不跨任务复用;只改训练参数的话,勾选「跳过缓存」可以直接续跑。真正的训练步数取决于「轮数 × 每轮样本数 × 批大小」,第一次建议用 20~30 张素材跑通流程再上量。